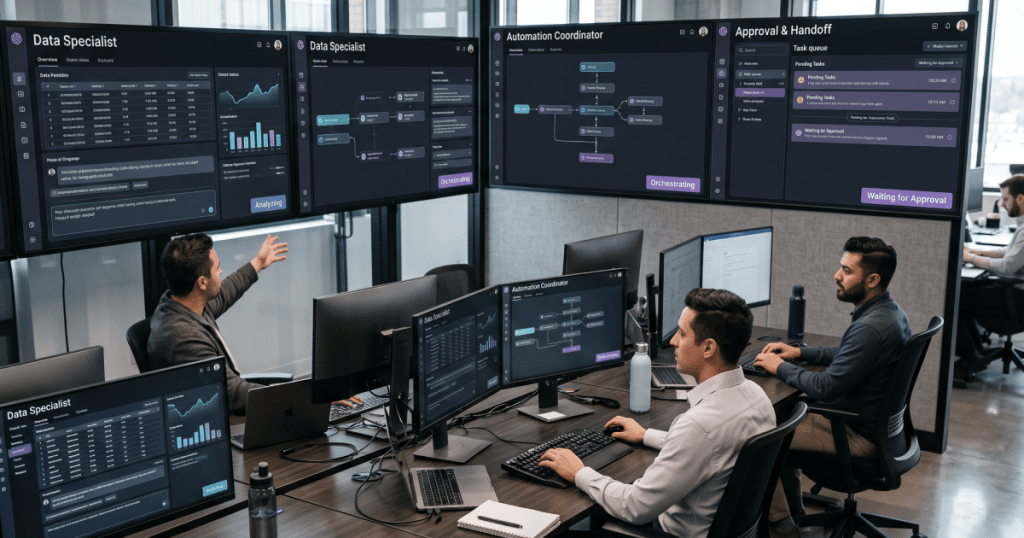
Em pagamentos instantâneos e jornadas digitais, a análise de risco precisa acontecer dentro da própria janela da transação. Uma operação via Pix leva segundos para ser concluída, e qualquer sistema que analise o risco depois da liquidação já chegou tarde.
Detecção de fraude em tempo real significa transformar sinais de transação, comportamento e contexto em uma decisão de risco antes que uma operação potencialmente fraudulenta gere impacto. Isso combina captura de dados, enriquecimento de contexto, regras, modelos de machine learning e mecanismos de resposta automatizada, tudo operando em milissegundos.
Neste artigo, explicaremos como essa detecção funciona na prática, quais sinais alimentam a análise, qual é o papel da inteligência artificial e o que uma arquitetura precisa ter para sustentar decisões em tempo real com confiabilidade.
O que é detecção de fraude em tempo real
Detecção de fraude em tempo real é o monitoramento e a análise de eventos conforme eles acontecem, com o objetivo de identificar comportamentos suspeitos e atribuir risco antes ou durante a conclusão de uma operação.
Três conceitos costumam ser tratados como sinônimos, mas respondem a propósitos diferentes. A detecção em tempo real avalia o risco enquanto a transação está em curso, permitindo agir antes que o impacto ocorra. O monitoramento pós-transação analisa operações já concluídas para identificar padrões suspeitos e acionar respostas como bloqueio de conta ou investigação. A prevenção de fraude, mais ampla, inclui controles anteriores à transação — autenticação, validação de identidade e limites operacionais.
Um sistema de detecção em tempo real é a camada que opera dentro da janela da transação, avaliando cada operação no momento em que ela acontece e decidindo o que fazer antes que seja concluída. Essa distinção importa porque define o que o sistema precisa fazer, em quanto tempo e com qual arquitetura.
Como funciona a detecção de fraude em tempo real
O processo de detecção em tempo real transforma um evento transacional em uma decisão de risco por meio de etapas encadeadas. Cada uma depende da anterior, e a qualidade do resultado final reflete a qualidade de todo o fluxo.
1. O sistema captura os sinais da operação
Quando uma transação é iniciada, o sistema coleta os dados disponíveis naquele momento: valor, tipo de operação, horário, canal, dispositivo utilizado, identificação do usuário e dados do destinatário ou beneficiário. Esses sinais formam o ponto de partida da análise, mas isoladamente dizem pouco sobre o risco real da operação.
2. Os dados são enriquecidos com contexto
O sistema cruza os sinais capturados com informações históricas e contextuais para ampliar a visão sobre aquela operação. Esse enriquecimento pode incluir o histórico de transações do usuário, o padrão de valores e horários habituais, os dispositivos conhecidos, a localização e o endereço IP, a frequência das operações recentes e o histórico de relacionamento com os beneficiários envolvidos.
Com esse contexto, o sistema consegue avaliar se aquela operação faz sentido para aquele perfil, ou se representa um desvio que merece atenção.
3. Regras e modelos avaliam comportamentos suspeitos
Com os dados enriquecidos disponíveis, o sistema aplica as camadas de análise. Regras determinísticas verificam situações previamente mapeadas, como transações acima de determinado valor em horários atípicos ou operações para destinatários nunca utilizados.
Modelos de machine learning avaliam padrões mais complexos e identificam desvios que regras fixas ainda não contemplam. As duas abordagens são complementares: as regras respondem bem a situações conhecidas e oferecem previsibilidade; os modelos lidam melhor com a complexidade e a adaptação a novos padrões de fraude.
4. A transação recebe uma pontuação de risco
O sistema combina os resultados da análise e calcula uma pontuação de risco para aquela operação — o score que representa a probabilidade estimada de que a transação seja fraudulenta. Este é o elemento central da decisão em tempo real, e precisa estar disponível em milissegundos para que a resposta aconteça ainda dentro da janela da transação.
5. O risco é convertido em uma ação
Com o score calculado, o sistema aciona a resposta correspondente. Dependendo do nível de risco e das regras configuradas, a operação pode ser aprovada automaticamente, encaminhada para autenticação adicional, colocada em fila para análise humana ou interrompida. A escolha entre essas ações depende tanto do score quanto de critérios de negócio definidos pela organização.
6. O resultado retroalimenta os modelos
O desfecho de cada transação — confirmada como fraude, validada como legítima ou identificada como falso positivo — retroalimenta o sistema. Fraudes confirmadas e transações legítimas ajudam na calibração contínua dos modelos e das regras, tornando o sistema progressivamente mais preciso sem depender de reescrita manual a cada novo padrão identificado.
Esse ciclo fechado entre captura, análise, decisão e aprendizado é o que diferencia sistemas de detecção maduros de soluções que apenas aplicam regras estáticas sobre eventos isolados.
Quais sinais ajudam a identificar uma fraude
A qualidade da detecção depende diretamente da riqueza dos sinais disponíveis para análise. Quanto mais contexto o sistema tem sobre aquela operação e aquele usuário, mais precisa tende a ser a avaliação de risco. Esses sinais se organizam em quatro camadas:
- Dados da transação: valor, horário, tipo de operação, canal utilizado, frequência de operações recentes e dados do beneficiário. São os sinais mais imediatos — dizem o que aconteceu, mas ainda não dizem se faz sentido acontecer;
- Dados de comportamento: padrão histórico de valores e horários, velocidade entre ações na sessão, sequência de interações no aplicativo e alterações abruptas de hábito. Uma transferência de alto valor para um novo destinatário pode ser completamente normal para um usuário que faz isso regularmente; para outro, pode ser um sinal relevante;
- Dados de dispositivo e acesso: dispositivo utilizado, endereço IP, localização geográfica e características da sessão. Uma operação iniciada num dispositivo nunca visto antes, com IP de localização incomum, carrega um conjunto de sinais diferente de uma operação feita no dispositivo habitual do usuário;
- Relações entre contas e entidades: conexões entre usuários, contas e beneficiários, especialmente úteis em esquemas coordenados ou lavagem de recursos. Sistemas mais maduros utilizam análise de grafos para identificar redes suspeitas, mesmo quando cada elemento individualmente não apresenta anomalia clara.
A combinação dessas camadas permite avaliar o risco com profundidade, e é o que torna o enriquecimento de dados uma etapa tão crítica quanto a análise em si.
Qual é o papel da IA na detecção de fraudes
A inteligência artificial amplia a capacidade de detecção ao identificar padrões que regras determinísticas isoladas não conseguem capturar com a mesma precisão. Sua contribuição se distribui em algumas funções complementares.
Aprendizado supervisionado para reconhecer padrões conhecidos
Modelos treinados com eventos previamente classificados como legítimos ou fraudulentos aprendem a reconhecer características associadas a cada categoria. Quando uma nova transação apresenta combinações de sinais semelhantes às de fraudes históricas, o modelo atribui um score de risco mais elevado, mesmo que nenhuma regra individual seja violada.
Detecção de anomalias para identificar comportamentos fora do padrão
Modelos de detecção de anomalias avaliam se uma transação representa um desvio estatístico em relação ao comportamento esperado, sem necessariamente ter visto aquele tipo específico de fraude antes. Essa capacidade é especialmente relevante para padrões novos ou variações de ataques já conhecidos.
Análise comportamental para contextualizar a operação
A modelagem comportamental constrói uma representação do comportamento típico de cada usuário ao longo do tempo. Com esse modelo, o sistema consegue avaliar se aquela operação específica faz sentido no contexto daquele usuário — considerando seus hábitos, preferências e histórico de interações.
Análise de relações e redes
Em casos mais complexos, a análise de grafos identifica conexões suspeitas entre contas, beneficiários e entidades que individualmente não apresentam anomalias evidentes. Essa abordagem amplia a visão do sistema para além da transação isolada e considera o contexto de relacionamento entre as partes envolvidas.
Cada uma dessas funções responde a um tipo diferente de risco. Ambientes maduros de detecção tendem a combinar mais de uma abordagem, justamente porque nenhuma delas cobre sozinha todo o espectro de comportamentos fraudulentos.
Regras antifraude e machine learning: uma relação complementar
A chegada de modelos de machine learning transformou o papel das regras na detecção de fraude, mas não as tornou obsoletas. Em ambientes maduros, as duas abordagens coexistem porque respondem a necessidades diferentes.
Regras determinísticas são eficazes para situações conhecidas e previamente mapeadas. Oferecem previsibilidade, são mais fáceis de auditar e permitem expressar critérios de negócio e requisitos regulatórios de forma explícita.
Modelos de machine learning, por sua vez, lidam melhor com padrões complexos, variações sutis e comportamentos que ainda não foram codificados em regras, especialmente úteis quando os padrões de fraude evoluem mais rápido do que a capacidade de atualização manual.
Na prática, a decisão final frequentemente combina os sinais das duas camadas: regras respondem ao que já é conhecido; modelos avaliam o que é complexo ou novo. Critérios de negócio, limites regulatórios e situações específicas do contexto operacional continuam sendo expressos em regras. A análise de padrões mais sutis e a adaptação a novos tipos de fraude ficam com os modelos. Em casos que exigem julgamento humano, ambas as camadas alimentam a decisão de escalonamento.
O ponto central é que as regras passaram a compartilhar a responsabilidade pela detecção — e isso, mais do que substituição, representa uma divisão mais inteligente do trabalho entre o que pode ser explicitado e o que precisa ser aprendido.
Como reduzir fraudes sem aumentar falsos positivos
O objetivo de um sistema antifraude vai além de bloquear operações suspeitas. Uma detecção excessivamente conservadora recusa clientes legítimos, interrompe jornadas e prejudica a conversão — custos reais para o negócio que nem sempre aparecem nos relatórios de fraude, mas que afetam receita e experiência do cliente de forma concreta.
O desafio é calibrar o sistema para que ele identifique fraudes com precisão suficiente sem prejudicar operações legítimas. Quatro elementos se reforçam mutuamente nessa calibração:
- Calibração dos thresholds de risco: definir em qual ponto o sistema bloqueia, solicita autenticação adicional ou aprova automaticamente depende do perfil de risco do negócio e do custo relativo de cada tipo de erro. Esse ponto raramente é fixo — tende a ser ajustado conforme o comportamento dos usuários e os padrões de fraude evoluem;
- Combinação de múltiplos sinais: trabalhar com sinais em conjunto tende a produzir avaliações mais precisas do que analisá-los isoladamente. Uma transação de alto valor fora do horário habitual, feita em dispositivo desconhecido para destinatário nunca utilizado, carrega um conjunto de sinais muito diferente de uma transação de mesmo valor feita no dispositivo habitual para um beneficiário frequente;
- Autenticação adicional em faixa de risco intermediário: para operações que não justificam bloqueio direto, solicitar uma confirmação adicional permite validar a legitimidade sem interromper a operação de forma definitiva — reduzindo falsos positivos sem abrir mão do controle sobre transações ambíguas;
- Acompanhamento contínuo de falsos positivos e negativos: fraudes evoluem, comportamentos mudam. Um sistema calibrado para o cenário de seis meses atrás pode estar desalinhado com o cenário atual. A revisão periódica dos modelos e das regras é parte da operação, não um ajuste eventual.
O que uma arquitetura precisa para detectar fraude em tempo real
O desempenho visível de um sistema antifraude — a decisão em milissegundos — é resultado de escolhas arquiteturais feitas nas camadas que o usuário não vê. Para que a detecção aconteça dentro da janela da transação, alguns elementos precisam estar presentes desde o início do desenho da solução.
Ingestão e processamento de eventos em baixa latência
Os dados precisam chegar enquanto a operação está acontecendo. Arquiteturas baseadas em streaming de eventos permitem capturar e processar sinais transacionais em tempo real, sem depender de ciclos de processamento em lote que tornariam a análise retrospectiva.
Integração entre diferentes fontes de dados
Transação, comportamento, dispositivo, histórico e contexto externo precisam conversar em tempo real. A capacidade de enriquecer um evento transacional com informações de múltiplas fontes, dentro da janela da operação, é o que torna a análise de risco genuinamente contextual — e é justamente o que diferencia uma avaliação superficial de uma avaliação precisa.
Qualidade e disponibilidade dos dados
Um modelo só consegue tomar uma decisão tão boa quanto o contexto que recebe. Dados inconsistentes, incompletos ou desatualizados comprometem diretamente a precisão da detecção, independentemente da sofisticação dos algoritmos aplicados sobre eles. A engenharia de dados que sustenta o sistema antifraude tem tanto impacto no resultado quanto os modelos em si.
Integração entre modelos, regras e mecanismos de resposta
O score de risco precisa chegar a algum lugar e produzir uma ação. A integração entre a camada de análise e os sistemas que executam as respostas — aprovação, autenticação adicional, bloqueio, fila de análise — precisa acontecer dentro da mesma janela de tempo da transação. Qualquer latência nesse encadeamento compromete a utilidade da detecção em tempo real.
Observabilidade do fluxo
Monitorar latência, volume, erros, performance dos modelos e comportamento do próprio sistema antifraude é parte da operação. Um sistema que detecta fraudes sem observabilidade torna difícil identificar quando sua performance começa a degradar — antes que esse degradamento se torne visível nos resultados.
A qualidade dos dados afeta os modelos; a latência da ingestão afeta a decisão; a observabilidade permite identificar e corrigir problemas em qualquer uma dessas camadas. Por isso, o desenho arquitetural de um sistema antifraude precisa considerar todas essas dimensões em conjunto desde o início.
Governança também faz parte da detecção de fraude
Um sistema antifraude em produção levanta questões que vão além da precisão técnica: quais dados alimentam as decisões, quem pode acessá-los, como as regras e os modelos são versionados e auditados e quais critérios definem quando uma decisão automatizada deve ser revisada por um humano.
Em serviços financeiros, a rastreabilidade das decisões é especialmente relevante. Reguladores e clientes podem questionar por que uma transação foi bloqueada, e o sistema precisa ser capaz de reconstruir o raciocínio por trás daquela decisão: quais sinais foram considerados, qual score foi atribuído e qual regra ou modelo determinou a ação. Sem essa rastreabilidade, a capacidade de responder a questionamentos regulatórios com evidências objetivas fica comprometida.
A privacidade dos dados utilizados na análise, o monitoramento contínuo de falsos positivos e falsos negativos e a definição clara de critérios para revisão humana completam a estrutura de governança que torna um sistema antifraude confiável para operar em escala. Para quem quiser aprofundar esse tema, a Nava tem um conteúdo dedicado aos riscos da IA no sistema financeiro e às estratégias para reduzir fraudes com governança.
Como a Nava apoia operações de detecção de fraude em tempo real
A detecção de fraude em tempo real depende da combinação entre arquitetura, dados, inteligência e capacidade de resposta. A Nava atua nesses pontos por meio de capacidades que cobrem diferentes camadas dessa operação.
Em dados e inteligência artificial, a atuação cobre engenharia de dados, machine learning para análise de padrões e anomalias e aplicação de IA em contextos de fraude e monitoramento de canais digitais. Em observabilidade, a Nava desenvolve plataformas que unificam dados e aceleram a detecção de falhas e comportamentos anômalos em operações de pagamento.
Essa combinação de arquitetura, dados, IA e observabilidade é o que permite estruturar sistemas capazes de identificar e responder a riscos dentro da janela da transação, com a confiabilidade que operações financeiras em escala exigem.
Fale com nossos especialistas para entender como estruturar arquiteturas de dados, IA e segurança preparadas para identificar e responder a riscos em tempo real.
Perguntas frequentes sobre detecção de fraude em tempo real
O que é detecção de fraude em tempo real?
É o monitoramento e a análise de eventos conforme eles acontecem, com o objetivo de identificar comportamentos suspeitos e atribuir risco antes ou durante a conclusão de uma operação. O sistema captura sinais da transação, enriquece com contexto histórico e comportamental, aplica regras e modelos para calcular um score de risco e aciona uma resposta — tudo dentro da janela da própria transação.
Como a inteligência artificial detecta fraudes?
A IA contribui principalmente por meio de aprendizado supervisionado, que reconhece padrões associados a fraudes históricas; detecção de anomalias, que identifica desvios em relação ao comportamento esperado; análise comportamental, que avalia se a transação faz sentido no contexto daquele usuário; e análise de redes, que mapeia conexões suspeitas entre contas e entidades.
Quais dados são analisados por um sistema antifraude?
Os sistemas combinam dados da transação, como valor, horário e canal; dados de comportamento, como padrão histórico e velocidade entre ações; dados de dispositivo e acesso, como IP, localização e aparelho utilizado; e relações entre contas e entidades. A combinação dessas camadas de sinais é o que permite avaliar o risco com profundidade.
Qual a diferença entre regras antifraude e machine learning?
Regras determinísticas são eficazes para situações conhecidas e previamente mapeadas, oferecem previsibilidade e são mais fáceis de auditar. Modelos de machine learning lidam melhor com padrões complexos e adaptação a novos tipos de fraude. Em ambientes maduros, as duas abordagens coexistem de forma complementar — regras respondem ao que já é conhecido; modelos avaliam o que é complexo ou novo.
O que é score de risco de fraude?
É a pontuação calculada pelo sistema para cada transação, representando a probabilidade estimada de que aquela operação seja fraudulenta. O score combina os resultados de regras, modelos e análise comportamental e é o elemento central da decisão em tempo real — precisa estar disponível em milissegundos para que a resposta aconteça dentro da janela da transação.
Como reduzir falsos positivos em sistemas antifraude?
A calibração dos thresholds de risco, a combinação de múltiplos sinais na análise, o uso de autenticação adicional em vez de bloqueio direto em casos de risco intermediário e o acompanhamento contínuo de falsos positivos e negativos são os principais mecanismos. O objetivo é identificar fraudes com precisão suficiente sem prejudicar operações legítimas.
Como funciona a detecção de fraude no Pix?
O Pix liquida em segundos, o que exige que a análise de risco aconteça antes da confirmação da transferência. Os sistemas antifraude avaliam em tempo real os sinais da transação e o comportamento do usuário, atribuem um score de risco e definem a resposta — aprovação, autenticação adicional ou bloqueio — dentro dessa janela estreita. A velocidade da liquidação é justamente o que torna a detecção em tempo real indispensável nesse canal.